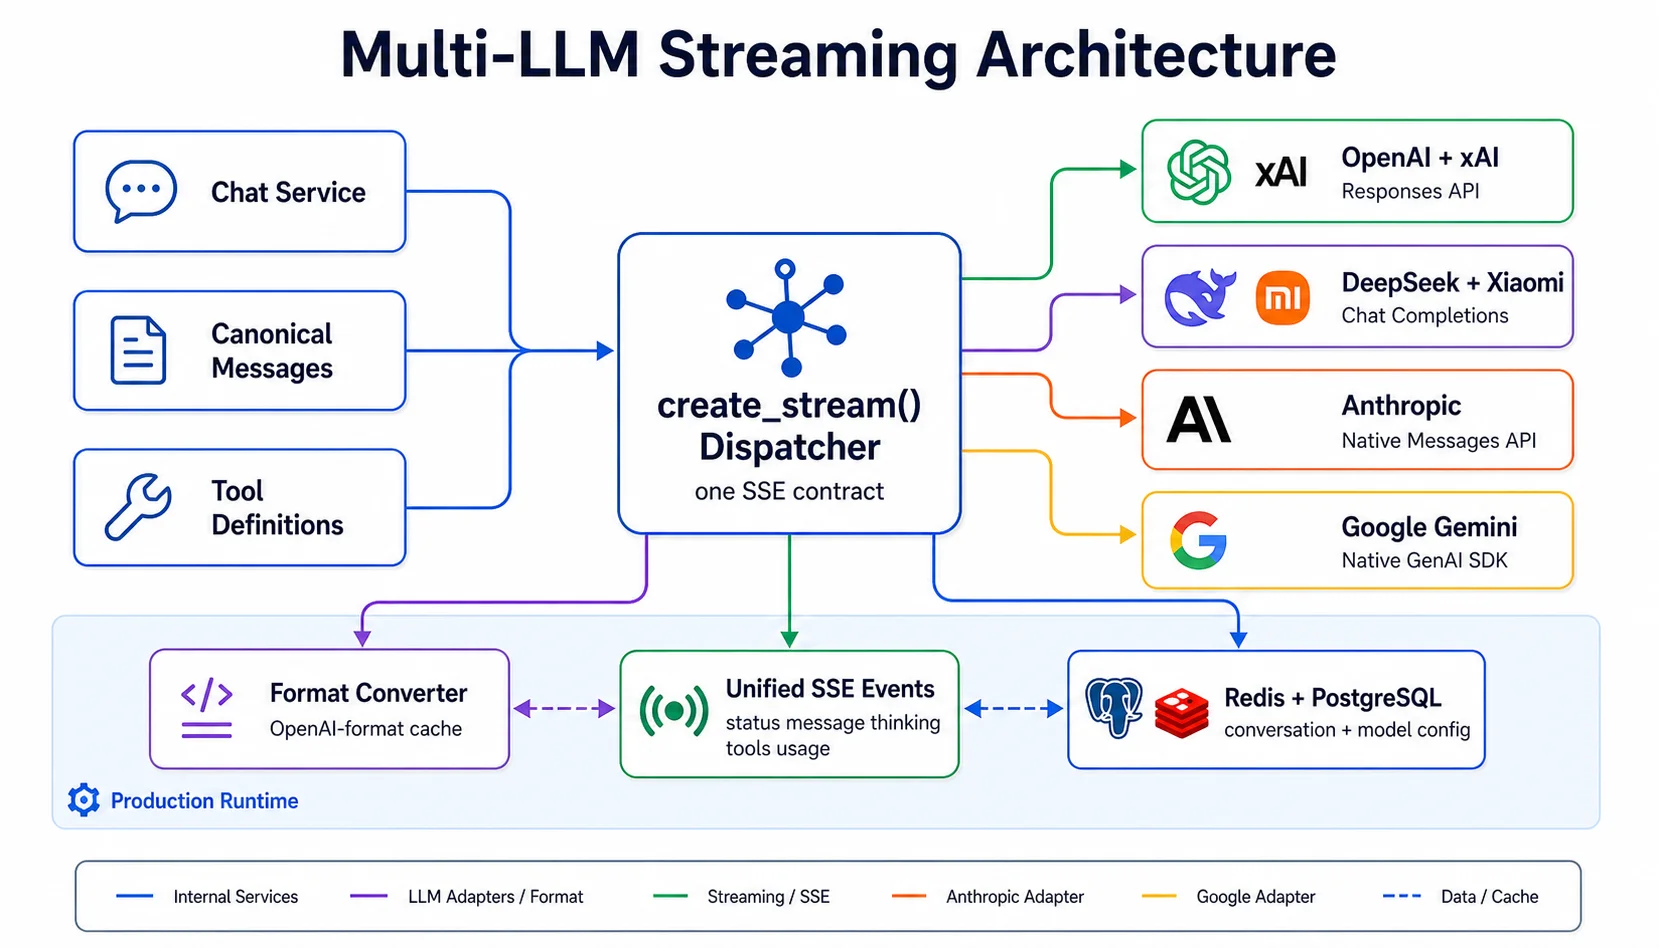
Khi xây một sản phẩm AI nghiêm túc, câu hỏi không phải "dùng model nào" mà là "làm sao đổi model mà không viết lại sản phẩm". Danh mục model đổi theo quý; kiến trúc bên dưới thì không, và đó mới là thứ đáng viết. Bài này mô tả cách runtime của Assistant Core phục vụ sáu nhà cung cấp bằng ba SDK, lưu lịch sử hội thoại theo một định dạng chuẩn, ánh xạ ba mức suy nghĩ sang tham số từng hãng, và những gì chúng tôi đo được về prompt caching.
Vì sao multi-LLM
- Mỗi tác vụ một model phù hợp. Hỗ trợ khách hàng khối lượng lớn cần model rẻ và nhanh; tác vụ nhiều bước công cụ cần model mạnh hơn; đầu vào âm thanh và video chỉ vài model nhận được.
- Giá và vòng đời. Các hãng đổi giá và ngừng model theo quý. Một tích hợp gắn chặt vào tên model phải viết lại mỗi lần như vậy; một tích hợp gắn vào hãng chỉ cần đổi cấu hình.
- Rủi ro một nhà cung cấp. Khi một hãng gặp sự cố, chủ sở hữu trợ lý đổi model trong Admin Panel và tiếp tục.
Một điểm cần nói rõ: OpenAI, Anthropic, Google và xAI là nhà cung cấp của chúng tôi, không phải đối thủ. Khách hàng không mang API key của riêng mình; mọi lượt gọi model tính bằng credit theo bảng credit, nơi mỗi model có giá đầu vào, đầu vào đã cache và đầu ra. Một lượt ví dụ (3.000 token vào, 800 token ra) tốn khoảng 1 credit với MiMo V2.6 Flash, GPT-6 Luna hay Haiku 5.5 và khoảng 42 credit với Opus 5.5, nên chọn đúng model cho đúng việc là quyết định chi phí lớn nhất sau caching.
Danh mục model
| Nhà cung cấp | Model trò chuyện | Ghi chú |
|---|---|---|
| OpenAI | GPT-6.1 Sol, GPT-6 Luna | Ngữ cảnh 1,05M token |
| Anthropic | Opus 5.5, Sonnet 5.5, Haiku 5.5 | Suy nghĩ luôn bật, chỉnh mức effort |
| Gemini 3.8 Flash, Gemini 3.5 Flash Lite | Nhận thêm âm thanh và video | |
| xAI | Grok 4.7, Grok 4.3 | |
| DeepSeek | DeepSeek Flash | Mặc định của nền tảng |
| Xiaomi | MiMo V2.6 Flash, MiMo V2.6 Pro | Đầu ra và đầu vào đã cache rẻ nhất |
Mọi model đều nhận văn bản và hình ảnh. Danh mục nằm trong cơ sở dữ liệu, nên đội nền tảng thêm, tắt hoặc đổi giá model mà không cần deploy; ô chọn model luôn hiển thị những gì đang dùng được. Xem Mô hình AI để biết model nào được chọn khi người dùng, chủ sở hữu và nền tảng cùng có cấu hình.
SDK gốc, không lớp trừu tượng
Chúng tôi không dùng LangChain hay một lớp trừu tượng chung. Lý do: lớp trừu tượng luôn đi sau nhà cung cấp. Prompt caching, chế độ suy nghĩ, configuration_update của Responses API, chữ ký thought của Gemini, mỗi thứ đến với một hãng trước và lớp trung gian cần hàng tuần để theo kịp. Khi lỗi xảy ra, việc gỡ lỗi qua ba tầng chậm hơn nhiều so với đọc request gửi đi.
Ba client phục vụ sáu hãng:
AsyncOpenAIgọi Responses API cho OpenAI, xAI, DeepSeek và Xiaomi MiMo.AsyncAnthropicgọi Messages API.google-genaicho Gemini.
"Tương thích OpenAI" là một phổ, không phải một chuẩn. Mỗi hãng cài một tập con của Responses API, và gửi một trường không hỗ trợ thì nhẹ nhất là bị bỏ qua, nặng là lỗi 400. Vì vậy mỗi hãng có một profile khai báo những gì được gửi:
@dataclass(frozen=True)
class ResponsesProfile:
    base_url: str | None
    send_store: bool = False               # store=false: lịch sử giữ phía client
    include_encrypted_reasoning: bool = False
    reasoning_summary: bool = False
    prompt_cache_key: CacheKeyScope | None = None
    pinned_reasoning_effort: str | None = None
    forced_tool_choice: bool = True
    parallel_tool_calls: bool = False

def create_stream(client, config, messages, tools, ...):
    if config.provider == ProviderCode.GOOGLE:
        return stream_gemini_native(...)
    if config.provider == ProviderCode.ANTHROPIC:
        return stream_anthropic_native(...)
    return stream_responses_api(..., RESPONSES_PROFILES[config.provider])
Một hàm điều phối, ba generator, và mỗi generator phát cùng một dòng sự kiện (trạng thái, văn bản, suy nghĩ, gọi công cụ, usage) cho phần còn lại của hệ thống.
Lịch sử hội thoại dạng chuẩn
Để đổi model giữa cuộc trò chuyện, lịch sử phải không thuộc về hãng nào. Định dạng chuẩn của chúng tôi là các item kiểu Responses API: message, function_call, function_call_output, reasoning và configuration_update. Các hãng tương thích Responses nhận gần như nguyên vẹn; adapter cho Anthropic và Gemini dịch sang định dạng gốc của họ.
Phần khó là trạng thái suy nghĩ. Mỗi hãng trả về reasoning dưới dạng mờ: OpenAI mã hóa, Gemini gắn chữ ký thought vào lời gọi hàm. Item reasoning được gắn nhãn hãng và model đã tạo ra nó, và chỉ được gửi lại cho đúng model đó; adapter của model khác bỏ qua nó. Kết quả là người dùng có thể đang chat với DeepSeek Flash, chuyển sang Sonnet 5.5, và Sonnet thấy toàn bộ tin nhắn và lời gọi công cụ trước đó, trừ suy nghĩ của model kia. Lịch sử giữ phía client (store=false) nên cách này cũng phù hợp với yêu cầu không lưu dữ liệu ở hãng.
Ngữ cảnh của mỗi lượt lấy từ Redis (12 giờ) và được dựng lại từ Postgres khi hết hạn. Kết quả công cụ cũ hơn hai lượt được thay bằng một dòng giữ chỗ, và khi một lượt dùng từ 64.000 token trở lên, một tác vụ nền tóm tắt phần đầu cuộc trò chuyện để ngữ cảnh không vượt giới hạn.
Ba mức suy nghĩ, sáu cách gọi
Người dùng thấy ba mức: Instant, Standard và Extended. Mỗi hãng nhận một giá trị khác:
| Hãng | Tắt | Instant | Standard | Extended |
|---|---|---|---|---|
| OpenAI, xAI | none | low | medium | high |
| Anthropic (Claude 5.5) | luôn bật, sàn low | low | medium | high |
| Google (Gemini 3) | sàn minimal | low | medium | high |
| DeepSeek | none | tắt | high | max |
| Xiaomi MiMo | none | tắt | bật | bật |
Claude 5.5 dùng thinking kiểu adaptive với output_config.effort; Gemini 3 không tắt hẳn được suy nghĩ; MiMo chỉ có bật hoặc tắt. Bài học: để sản phẩm có một khái niệm, rồi ánh xạ xuống tham số gốc của từng hãng, thay vì lộ tham số của hãng lên giao diện.
Prompt caching: đo, đừng tin tài liệu
Caching là tối ưu có ảnh hưởng lớn nhất tới chi phí vận hành. Trên bảng credit, token đầu vào đã cache của GPT-6 Luna và Haiku 5.5 rẻ hơn 10 lần so với token thường. Mỗi hãng có một cơ chế, và vài điều chỉ biết khi đo.
- Anthropic cache tường minh qua
cache_control. Chúng tôi dùng 3 trong 4 breakpoint: system prompt, công cụ cuối cùng, và breakpoint tự động ở cấp request trượt dần theo cuộc trò chuyện. TTL là 1 giờ thay vì 5 phút mặc định, vì người dùng chat thường trả lời cách nhau 5 đến 60 phút. Thứ tự cache là công cụ, system, rồi tin nhắn; các block suy nghĩ được gửi lại nguyên vẹn nên mỗi vòng gọi công cụ vẫn trúng cache. Khi đo, đổi mức effort giữa hai lượt không làm mất cache trên Claude 5.5, dù tài liệu nói ngược lại. Xem tài liệu prompt caching của Anthropic. - OpenAI cache tự động từ 1.024 token. Chúng tôi gửi
prompt_cache_keytheo người dùng, nên một cuộc trò chuyện mới tái sử dụng tiền tố công cụ và system prompt mà người dùng vẫn tách biệt. Với GPT-6,reasoning.effortnằm trong tiền tố được cache, nên nó được ghim một giá trị và mức effort của từng lượt gửi bằng itemconfiguration_update. Các lời gọi một lần (đặt tiêu đề, gợi ý) chọn không ghi cache để tránh phụ phí ghi. Xem tài liệu của OpenAI. - xAI dùng khóa cache là id cuộc trò chuyện để định tuyến ổn định. Trên grok-4.3, đổi mức effort làm cache rơi xuống 128 token, kể cả system prompt, và
configuration_updatebị từ chối, nên chúng tôi không có cách vòng. Tỷ lệ trúng cache của xAI nhiễu; muốn kết luận gì phải chạy nhiều lần. - Gemini cache tiền tố ngầm định: system instruction và công cụ đứng đầu mọi request là đủ. Xem context caching của Gemini.
- DeepSeek và MiMo cache tự động, không cần cấu hình.
Quy tắc rút ra: luôn bật caching, luôn đọc trường usage để biết bao nhiêu token thật sự trúng cache, và đo lại sau mỗi lần hãng đổi model.
Gọi công cụ trên sáu hãng
Định nghĩa công cụ dùng một định dạng hàm chung, chia sẻ với cả các nhà cung cấp giọng nói. Khác biệt nằm ở chi tiết:
| Hãng | Gọi song song | Ép gọi một công cụ |
|---|---|---|
| OpenAI, xAI | Bật | Có |
| DeepSeek | Tự động | Có |
| Xiaomi MiMo | Tự động | Không, chỉ auto |
| Anthropic | Có | Không khi thinking bật, để auto |
| Có | Có, qua tool_config |
Trước khi gửi, các phần media mà model không nhận (ví dụ video gửi cho model chỉ nhận ảnh) được thay bằng ghi chú văn bản, nên đổi model không làm request lỗi. Cách công cụ, MCP và local connector được nối vào trợ lý nằm trong bài MCP cho trợ lý AI.
Model theo cấu hình, không theo deploy
Model là dữ liệu: bảng AIModel lưu mã model, hãng, loại đầu vào và trạng thái bật. Chủ sở hữu chọn model cho trợ lý trong Admin Panel, người dùng chọn cho cuộc trò chuyện của mình trong web app, và API nhận model theo từng request; lựa chọn có giá trị đầu tiên theo thứ tự đó được dùng, cuối cùng là mặc định của nền tảng. Không cần restart. Điều không đổi được bằng cấu hình là thêm một hãng mới: việc đó vẫn cần code, một enum và một profile hoặc adapter. Chúng tôi nói "đổi model qua cấu hình", không nói "cắm bất kỳ hãng nào".
Gợi ý chọn model
- Bắt đầu với mặc định DeepSeek Flash và bật caching.
- Hỗ trợ khách hàng khối lượng lớn: Haiku 5.5, GPT-6 Luna hoặc MiMo V2.6 Flash, nơi cache đầu vào rẻ nhất.
- Tác vụ nhiều bước công cụ hoặc tài liệu dài: Sonnet 5.5, Opus 5.5 hoặc GPT-6.1 Sol.
- Đầu vào âm thanh hoặc video: Gemini 3.8 Flash.
- Đo chi phí theo lượt trên bảng credit trước khi đổi mặc định cho mọi người dùng.
Cách người dùng tự chọn model trong web app nằm ở Chọn mô hình. Lớp truy xuất tài liệu không phụ thuộc model, xem RAG trên pgvector.